Glosario de Inteligencia Artificial
En 1956, John McCarthy acuñó la expresión «inteligencia artificial», y la definió como «la ciencia e ingenio de hacer máquinas inteligentes, especialmente programas de cómputo inteligentes».
Anonymization (Anonimato): Renovar u ocultar información de manera que la fuente no pueda identificarse de manera única.
Artificial intelligence (Inteligencia artificial): Programar computadoras para hacer cosas que, si fueran hechas por humanos, diría que requieren “inteligencia”. Es un término humano centrado y ambiguo: llamar a las computadoras ”artificialmente inteligentes ” es como llamar a la conducción de un automóvil “correr artificialmente”.
Association rules (reglas de asociación): Asociar dos o más artículos en el análisis de la cesta (basket analysis). Por ejemplo, “Las personas que compran pañales con usualmente también compran cerveza”.
Autoencoder network (Red autocodificadora): Un tipo de red neuronal que está entrenada para reconstruir su entrada en su salida. Debido a que hay menos unidades ocultas intermedias que ingresan, la red se ve obligada a aprender una representación comprimida corta en las unidades ocultas, que puede interpretarse como un proceso de abstracción.
Backpropagation (retropropagación): Un algoritmo de aprendizaje para redes neuronales artificiales utilizado para el aprendizaje supervisado, donde los pasos de conexión se actualizan iterativamente para disminuir el error de aproximación en las unidades de salida.
Bag of words (Bolsa de palabras): Un método para la representación de documentos donde preseleccionamos un léxico de N palabras y representamos cada documento por una lista de longitud N donde el elemento i es 1 si la palabra i existe en el documento y es 0 de lo contrario.
Class (clase): Un conjunto de instancias que tienen la misma identidad. Por ejemplo, ‘A’ y A’ pertenecen a la misma clase. En el aprendizaje automático, para cada clase aprendemos un discriminante del conjunto de sus ejemplos.
Classification (Clasificación): Asignación de una instancia dada a una de un conjunto de clases.
Cloud Computing (nube informática): Es un paradigma reciente en informática donde la información y el computo de datos no están almacenados localmente pero se encuentran a la mano en algún sitio remoto de centro de datos. Existen varios centros de datos de este tipo, y las tareas de diferentes usuarios se distribuyen sobre ellos de una manera invisible para el usuario. Anteriormente era conocido como Computation Grid (computación en malla)
Clustering (agrupamiento): Agrupación de instancias similares en grupos. Este es un método de aprendizaje no supervisado porque las instancias que forman un grupo se encuentran en función de su similitud entre sí, en lugar de una tarea de clasificación en la que el supervisor asigna instancias a las clases etiquetándolas explícitamente.
Connectionism (Conexionismo): Un enfoque de red neuronal en la ciencia cognitiva donde la mente se modela como la operación de una red de muchas unidades de procesamiento simples que se ejecutan en paralelo. También se conoce como procesamiento distribuido paralelo.
Cyber-physical Systems (Sistemas ciberfísicos): Elementos computacionales que interactúan directamente con el mundo físico. Algunos pueden ser móviles. Se puede organizar como una red para manejar la tarea de manera colaborativa. También conocido como sistemas embebidos.
Data Analysis (Análisis de los datos): Métodos computacionales para extraer información de grandes cantidades de datos. La minería de datos utiliza el aprendizaje automático y se basa más en datos; OLAP (siglas en ingles de procesamiento analítico en línea) está más orientado al usuario.
Data Mining (Minería de datos): Aprendizaje automático (Machine Learning) y métodos estadísticos para extraer información de una gran cantidad de datos. Por ejemplo, en el análisis de la cesta, al analizar un gran número de transacciones, encontramos reglas de asociación.
Data Science (Ciencia de los datos): Un campo recientemente propuesto en ciencias de la computación e ingeniería compuesto por aprendizaje automático, computación de alto rendimiento y privacidad / seguridad de datos. Se propone que la ciencia de datos maneje de manera sistemática los problemas de “big data” que enfrentamos en muchos escenarios diferentes.
Data Warehouse (Almacén de datos): Un subconjunto de datos seleccionados, extraídos y organizados para una tarea específica de análisis de datos. Los datos originales pueden ser muy detallados y pueden estar en varias bases de datos operativas diferentes. El almacén los fusiona y los resume. El almacén es de solo lectura; se utiliza para obtener una visión general de alto nivel del proceso que subyace a los datos, ya sea a través de OLAP y herramientas de visualización, o mediante software de minería de datos.
Database (Base de datos): Software para almacenar y procesar información representada digitalmente de manera eficiente.
Decision tree (Árbol de decisión): Un modelo jerárquico compuesto por nodos de decisión y hojas (leaves). El árbol de decisiones funciona rápido y se puede convertir a un conjunto de reglas if-then (si x cosa-entonces), y como tal permite la extracción de conocimiento.
Deep Learning (Aprendizaje profundo): Métodos que se utilizan para entrenar modelos con varios niveles de abstracción desde la entrada sin formato hasta la salida. Por ejemplo, en el reconocimiento visual, el nivel más bajo es una imagen compuesta de píxeles. En las capas a medida que avanzamos, un alumno profundo los combina para formar trazos y bordes de diferentes orientaciones, que luego se pueden combinar para detectar líneas, arcos, esquinas y uniones más largas, que a su vez se pueden combinar para formar rectángulos, círculos, y así. Las unidades de cada capa pueden pensarse en un conjunto de primitivas en un nivel diferente de abstracción.
Dimensionality reduction (Reducción de dimensionalidad): Métodos para disminuir el número de atributos de entrada. En una aplicación, algunas de las entradas pueden no ser informativas, y algunas pueden corresponder a diferentes formas de proporcionar la misma información. Reducir el número si las entradas también reduce la complejidad del modelo aprendido y facilita el seguimiento. Ver selección de características y extracción de características.
Discriminant (Discriminante): Una regla que define las condiciones para que una instancia sea un elemento de una clase y, como tal, las separa de las diferencias de otras clases.
Document categorization (Categorización de documentos): Clasificación de texto, documentos, generalmente basada en las palabras que aparecen en el texto (por ejemplo, usando la representación de bolsa de palabras). Por ejemplo, los documentos de noticias pueden clasificarse en política, artes, deportes, etc. Los correos electrónicos pueden clasificarse como spam versus no spam.
Face recognition (Reconocimiento de la cara): Reconociendo las identidades de las personas a partir de sus imágenes faciales capturadas por una cámara.
Feature recognition (Reconocimiento de funciones): Reconocer la identidad de las personas a partir de las imágenes de sus caras capturadas por una cámara.
Feature extraction (Extracción de funciones): Como método para la reducción de la dimensionalidad, se combinaron varias entradas originales para definir nuevas características informativas.
Feature selection (Selección de características): Un método que descarta las características uniformes y mantiene solo aquellas que son informativas. Es otro método de reduccion de la dimensionalidad.
Generalization (Generalización): Que tan bien se desempeña un modelo entrenado en el conjunto de entrenamiento con los nuevos datos no vistos durante el entrenamiento. Esto está en el núcleo del aprendizaje automático. En un examen, una maestra hace preguntas que son diferentes de los ejercicios que ha resuelto mientras enseñaba el curso, y el rendimiento de un alumno se mide en función de su rendimiento en estas nuevas preguntas. Un estudiante que puede resolver solo las preguntas que el instructor ha resuelto en clase no es lo suficientemente bueno.
Generative model (Modelo generativo): Un modelo definido de tal manera que represente la forma en que creemos que se han generado los datos. Pensamos en causas ocultas que generan los datos y también en causas ocultas de nivel superior. Las carreteras resbaladizas pueden causar accidentes, y la lluvia puede haber causado que las carreteras estén resbaladizas.
Graphical model (Modelo grafico): Un modelo que representa dependencias entre conceptos probabilísticos. Cada nodo es un concepto con un grado de verdad diferente y la conexión entre nodos representa una dependencia condicional. Si sé que la lluvia hace que mi hierba se moje, defino un nodo para la lluvia y un nodo para la hierba húmeda, y pongo una conexión directa desde el nodo de lluvia al nodo para la hierba húmeda. La inferencia probabilística en tales redes puede implementarse como algoritmos de gráficos eficientes. Dichas redes son una representación visual y esto ayuda a entender. También conocida como red bayesiana: una regla de interferencia utilizada en tales redes en la regla de Bayes.
High-performance computing (Computación de alto rendimiento): Para manejar los problemas de big data que tenemos hoy en un tiempo razonable, necesitamos sistemas informáticos potentes, tanto para el almacenamiento como para el cálculo. El campo de la informática de alto rendimiento incluye el trabajo en estas direcciones. El enfoque es la computación en la nube.
If-then rules (Reglas si-entonces): Reglas de decisión escritas en la forma de ”SI antecedente ENTONCES consecuente ” El antecedente es una condición lógica y si es cierto para la entrada, la acción en el consecuente se lleva a cabo. En el aprendizaje supervisado, el consecuente corresponde a elegir un determinado resultado. Una base de reglas compuesta de muchas reglas si-entonces. Un modelo que se puede escribir como un conjunto de reglas if-then es fácil de entender y, por lo tanto, las bases de reglas permiten la extracción de conocimiento.
Ill-posed problem (Problema mal planteado): Un problema donde los datos no son suficientes para encontrar una solución única. Ajustar un modelo a los datos es un problema mal planteado, y necesitamos hacer suposiciones adicionales para obtener un modelo único; tales supuestos se denominan sesgo inductivo de un algoritmo de aprendizaje.
Knowledge extraction (Extracción de conocimiento): En algunas aplicaciones, especialmente en minería de datos, después de entrenar un modelo, nos gustaría poder entender lo que el modelo ha aprendido; esto puede ser utilizado para validar el modelo por personas expertas en esa aplicación, y también ayuda a comprender el proceso que generó los datos. Algunos modelos son ”caja negra” porque no son fáciles de entender; Algunos modelos, por ejemplo, modelos lineales y árboles de decisión, son interpretables y permiten extraer conocimiento de un modelo entrenado.
Latent semantic analysis (Análisis semántico latente): Un método de aprendizaje donde el objetivo es encontrar un pequeño conjunto de variables ocultas (latentes) que representan las dependencias en una gran muestra de datos observados. Dichas variables ocultas pueden corresponder a conceptos abstractos (por ejemplo, semánticos). Por ejemplo, se puede decir que cada artículo de noticias incluye una serie de “temas”, y aunque la información de este tema no se proporciona explícitamente de manera supervisada en los datos, podemos aprenderlos de los datos de tal manera que cada tema esté definido por un conjunto particular de palabras y cada artículo de noticias se define por un conjunto particular de temas.
Model (Modelo): Una plantilla que formaliza la relación entre una entrada y una salida. Su estructura es fija pero también tiene parámetros modificables; los parámetros se ajustan para que el mismo modelo con diferentes parámetros pueda ser entrenado en diferentes datos para implementar diferentes relaciones en diferentes tareas.
Natural language processing (Procesamiento natural del lenguaje): Métodos informáticos utilizados para procesar el lenguaje humano, también llamado lingüística computacional.
Regression (regresión): Estimando un valor numérico para una instancia dada. Por ejemplo, estimar el precio de un automóvil usado dados los atributos del es un problema de regresión.
Reinforcement learning (aprendizaje reforzado): También se conoce como aprender con la crítica. El agente realiza una secuencia de acciones y recibe una recompensa / penalización solo al final, sin retroalimentación durante las acciones intermedias. Usando esta información limitada, el agente debe aprender a generar las acciones para maximizar la recompensa en ensayos posteriores. Por ejemplo, en ajedrez, hacemos una serie de movimientos, y al final, ganamos o perdemos el juego; Por lo tanto, debemos determinar cuáles fueron las acciones que nos llevaron a este resultado y atribuirles el correspondiente crédito.
Sample (muestreo): Un conjunto de datos observados. En estadística, hacemos una diferencia entre una población y una muestra. Digamos que queremos hacer un estudio sobre la obesidad en estudiantes de escuela. La población son todos los estudiantes de secundaria, y no podemos observar el peso de todos. En su lugar, elegimos un subconjunto aleatorio de, por ejemplo, 1000 estudiantes y observamos sus pesos. Esos 1000 valores son nuestra muestra. Analizamos la muestra para hacer interferencias sobre la población. Cualquier valor que calculamos a partir de la muestra es una estadística. Por ejemplo, el promedio de los pesos de los 1000 estudiantes en la muestra es una estadística y es un estimador de la media de la población.
Smart device (Dispositivo inteligente) :Un dispositivo que tiene sus datos detectados representados digitalmente y está haciendo algunos cálculos sobre estos datos. El dispositivo puede ser móvil y puede estar en línea, es decir, tiene la capacidad de intercambiar datos con otros dispositivos inteligentes, computadoras o la nube.
Speech recognition (Reconocimiento de voz): Reconocer oraciones expresadas a partir de información acústica capturada por un micrófono.
Supervised learning (Aprendizaje supervisado): Un tipo de aprendizaje automático en el que el modelo aprende a generar la salida correcta para cualquier entrada. El modelo está entrenado con datos preparados por un supervisor que puede proporcionar la salida deseada para una entrada dada. La clasificación y la regresión son ejemplos de aprendizaje supervisado.
Validation (Validación): Probar el rendimiento de generalización de un modelo entrenado probándolo en datos. invisible durante el entrenamiento. Por lo general, en el aprendizaje automático, dejamos algunos de nuestros datos como datos de validación y, después del entrenamiento, los probamos en estos datos que quedan. Esta precisión de validación es un estimador de qué tan bien se espera que funcione el modelo si se usa más adelante en la vida real.
Web Scraping (Raspado web): Software que navega automáticamente por la web y extrae información de las páginas web.
En esta entrada

Cristóbal Valenzuela
Cristóbal Valenzuela (nacido en Chile, radicado en USA). Trabaja en el desarrollo y exploración de herramientas creativas utilizando la inteligencia artificial. Es tecnólogo, artista y desarrollador de software, con particular interés en la intersección entre la inteligencia artificial y las creaciones individuales/colectivas, explorando
Cristóbal Valenzuela
Cristóbal Valenzuela (nacido en Chile, radicado en USA). Trabaja en el desarrollo y exploración de herramientas creativas utilizando la inteligencia artificial. Es tecnólogo, artista y desarrollador de software, con particular interés en la intersección entre la inteligencia artificial y las creaciones individuales/colectivas, explorando

Esto no es una pipa
Ceci n’est pas une pipe (esto no es una pipa) cuadro pintado por René Magritte en 1928 como parte de la serie “La traición de las imágenes”. El filósofo francés Michel Foucault habla del cuadro y su paradoja en su libro
Esto no es una pipa
Ceci n’est pas une pipe (esto no es una pipa) cuadro pintado por René Magritte en 1928 como parte de la serie “La traición de las imágenes”. El filósofo francés Michel Foucault habla del cuadro y su paradoja en su libro

Texel
El Texel (del inglés: texture element, o texture pixel) es la unidad mínima de una textura 3d utilizada por gráficos diseñados por ordenador. La unidad mínima de la superficie de una pared 3d es un texel, mientras que la unidad mínima
Texel
El Texel (del inglés: texture element, o texture pixel) es la unidad mínima de una textura 3d utilizada por gráficos diseñados por ordenador. La unidad mínima de la superficie de una pared 3d es un texel, mientras que la unidad mínima

Young-Hae Chang Heavy Industries
Desde 1997, Young-hae Chang y Marc Voge trabajan juntos bajo el nombre de Young-hae Chang Heavy Industries (YHCHI). Adoptando el modelo de una corporación ficticia, producen obras de arte para Internet y en línea que siguen una fórmula estricta: películas
Young-Hae Chang Heavy Industries
Desde 1997, Young-hae Chang y Marc Voge trabajan juntos bajo el nombre de Young-hae Chang Heavy Industries (YHCHI). Adoptando el modelo de una corporación ficticia, producen obras de arte para Internet y en línea que siguen una fórmula estricta: películas

Software Takes Command
Software Takes Command es un libro del teórico e investigador Lev Manovich editado en 2013. Es un texto sobre los estudios de software en un intento de definir Software Cultural. “Mi objetivo no es proporcionar una historia completa del software cultural
Software Takes Command
Software Takes Command es un libro del teórico e investigador Lev Manovich editado en 2013. Es un texto sobre los estudios de software en un intento de definir Software Cultural. “Mi objetivo no es proporcionar una historia completa del software cultural

Aprendizaje profundo
Aprendizaje profundo (deep learning) se llama a la utilización de algoritmos específicos aprendizaje automático (machine learning) que tienen como propósito y función intentar modelar datos partiendo de abstracciones complejas, utilizando arquitecturas compuestas de transformaciones no lineales múltiples. El aprendizaje profundo es parte de un conjunto aún
Aprendizaje profundo
Aprendizaje profundo (deep learning) se llama a la utilización de algoritmos específicos aprendizaje automático (machine learning) que tienen como propósito y función intentar modelar datos partiendo de abstracciones complejas, utilizando arquitecturas compuestas de transformaciones no lineales múltiples. El aprendizaje profundo es parte de un conjunto aún

RNDR
RNDR es la primera red que transforma el poder de las GPU (unidad de procesamiento gráfico por sus siglas en inglés) en una economía descentralizada. El propósito es hacer posible que cualquier objeto o entorno 3D sea autorizado, distribuido y monetizado a
RNDR
RNDR es la primera red que transforma el poder de las GPU (unidad de procesamiento gráfico por sus siglas en inglés) en una economía descentralizada. El propósito es hacer posible que cualquier objeto o entorno 3D sea autorizado, distribuido y monetizado a

Glosario Big Data
Glosario big data Big data: Volumen de información cuya gestión es muy difícil siguiendo los métodos tradicionales de tratamiento de información. Smart data: Aquella información válida y con sentido para extraer conclusiones que lleven a tomas de decisiones para cualquier tipo
Glosario Big Data
Glosario big data Big data: Volumen de información cuya gestión es muy difícil siguiendo los métodos tradicionales de tratamiento de información. Smart data: Aquella información válida y con sentido para extraer conclusiones que lleven a tomas de decisiones para cualquier tipo

Visualización de Datos
La visualización de datos es visto por muchas disciplinas como un equivalente moderno de la comunicación visual. No es propiedad de algun campo especifico, sino más bien se encuentra bajo la interpretación a través de muchas disciplinas (por ejemplo, es
Visualización de Datos
La visualización de datos es visto por muchas disciplinas como un equivalente moderno de la comunicación visual. No es propiedad de algun campo especifico, sino más bien se encuentra bajo la interpretación a través de muchas disciplinas (por ejemplo, es

allRGB
El objetivo de allRGB es simple: crear imágenes con un píxel de cada color RGB posible (16777216), sin que falte ni se repita ninguno. Para la profundidad de color de 24 bits por pixel, se habla de color verdadero debido a que

Activismo Hacker
* Los hackers deberán ser juzgados por sus hackeos, no por falsos criterios como títulos, edad, raza, o posición. * En una computadora se puede crear arte y belleza. * Las computadoras pueden cambiar la vida para mejor. Bonsembiante, F.
Activismo Hacker
* Los hackers deberán ser juzgados por sus hackeos, no por falsos criterios como títulos, edad, raza, o posición. * En una computadora se puede crear arte y belleza. * Las computadoras pueden cambiar la vida para mejor. Bonsembiante, F.

Sueño Profundo
Deep Dream es un proyecto de investigación sobre redes neuronales artificiales llevado a cabo por los ingenieros Alexander Mordvintsev, Christopher Olah y Mike Tyka basado en la plataforma de reconocimiento de imágenes de Google. Una red neuronal tiene entre diez y
Sueño Profundo
Deep Dream es un proyecto de investigación sobre redes neuronales artificiales llevado a cabo por los ingenieros Alexander Mordvintsev, Christopher Olah y Mike Tyka basado en la plataforma de reconocimiento de imágenes de Google. Una red neuronal tiene entre diez y

George Boole
George Boole, (Gran Bretaña 1815 – 1864), fue un matemático y lógico británico. Como inventor del álgebra de Boole, que marca los fundamentos de la aritmética computacional moderna, Boole es considerado como uno de los fundadores del campo de las
George Boole
George Boole, (Gran Bretaña 1815 – 1864), fue un matemático y lógico británico. Como inventor del álgebra de Boole, que marca los fundamentos de la aritmética computacional moderna, Boole es considerado como uno de los fundadores del campo de las

Instituto de la UNESCO para TICs
El auge de los nuevos medios electrónicos y de las TIC (Tecnologías de la Información y la Comunicación) produce un efecto de revisión y de auto evaluación de los sistemas, contenidos y métodos en la educación primaria, secundaria y universitaria.
Instituto de la UNESCO para TICs
El auge de los nuevos medios electrónicos y de las TIC (Tecnologías de la Información y la Comunicación) produce un efecto de revisión y de auto evaluación de los sistemas, contenidos y métodos en la educación primaria, secundaria y universitaria.

Jaron Lanier
Jaron Lanier (Estados Unidos, 1960). Nació en Nueva York y vivió en Mesilla, Nuevo México. Hijo de inmigrantes judíos, curso estudios de postgrado a los 13 años en la Universidad estatal de Nuevo México, obtuvo la beca Fundación Nacional para
Jaron Lanier
Jaron Lanier (Estados Unidos, 1960). Nació en Nueva York y vivió en Mesilla, Nuevo México. Hijo de inmigrantes judíos, curso estudios de postgrado a los 13 años en la Universidad estatal de Nuevo México, obtuvo la beca Fundación Nacional para
Wikileaks
Wikileaks desarrolla una versión no censurable de Wikipedia para la publicación masiva y el análisis de documentos secretos (“Leaks”), manteniendo a sus autores en el anonimato. Su creador es Julian Assange (Austalia, 1971) y está gestionado por The Sunshine Press. Su slogan: Abrimos
Wikileaks
Wikileaks desarrolla una versión no censurable de Wikipedia para la publicación masiva y el análisis de documentos secretos (“Leaks”), manteniendo a sus autores en el anonimato. Su creador es Julian Assange (Austalia, 1971) y está gestionado por The Sunshine Press. Su slogan: Abrimos

El arte de programar ordenadores
Escrito en 1968 por Donal Knuth (EEUU, 1938), El arte de programar computadoras, es una de las más respetadas referencias en el campo de las ciencias de la computación. Sentó las bases y dio nombre al análisis de algoritmos, y
El arte de programar ordenadores
Escrito en 1968 por Donal Knuth (EEUU, 1938), El arte de programar computadoras, es una de las más respetadas referencias en el campo de las ciencias de la computación. Sentó las bases y dio nombre al análisis de algoritmos, y
Félix Luque Sánchez
Félix Luque Sánchez, (España, 1976). Artista que ha desarrollado una línea de investigación artística muy personal, que plasma en grandes instalaciones, caracterizadas por una estética cercana al mundo de la ciencia ficción. Canal de Vimeo de Felix Luque: vimeo.com/felixluque Se
Félix Luque Sánchez
Félix Luque Sánchez, (España, 1976). Artista que ha desarrollado una línea de investigación artística muy personal, que plasma en grandes instalaciones, caracterizadas por una estética cercana al mundo de la ciencia ficción. Canal de Vimeo de Felix Luque: vimeo.com/felixluque Se
WWW
En informática, la World Wide Web (WWW) o Red informática mundial es un sistema de distribución de información basado en hipertexto o hipermedios enlazados y accesibles a través de Internet. Con un navegador web, un usuario visualiza sitios web compuestos
WWW
En informática, la World Wide Web (WWW) o Red informática mundial es un sistema de distribución de información basado en hipertexto o hipermedios enlazados y accesibles a través de Internet. Con un navegador web, un usuario visualiza sitios web compuestos

Memex
Dispositivo ideado por el científico e ingeniero Vannevar Bush (USA, 1890 – 1974), destinado a la búsqueda de información almacenada en una base de datos, considerado unos de los precursores del hipertexto y la world wide web. Si bien el mismo nunca
Memex
Dispositivo ideado por el científico e ingeniero Vannevar Bush (USA, 1890 – 1974), destinado a la búsqueda de información almacenada en una base de datos, considerado unos de los precursores del hipertexto y la world wide web. Si bien el mismo nunca

Algorithmic Art Assembly
Algorithmic Art Assembly es una conferencia de dos días y festival de música, que muestra una amplia gama de artistas que utilizan herramientas y procesos algorítmicos en sus obras. Canal de Youtube de Algorithmic Art Assembly Desde codificación en vivo
Algorithmic Art Assembly
Algorithmic Art Assembly es una conferencia de dos días y festival de música, que muestra una amplia gama de artistas que utilizan herramientas y procesos algorítmicos en sus obras. Canal de Youtube de Algorithmic Art Assembly Desde codificación en vivo

Ética hacker
La ética del hacker y el espíritu de la era de la información (titulo original: The hacker ethic and the spirit of the information age), libro escrito en 2001 por Pekka Himanen (Finlandia, 1973). Prólogo: En el centro de nuestra
Ética hacker
La ética del hacker y el espíritu de la era de la información (titulo original: The hacker ethic and the spirit of the information age), libro escrito en 2001 por Pekka Himanen (Finlandia, 1973). Prólogo: En el centro de nuestra

Ada Lovelace
Augusta Ada King, Condesa de Lovelace, nacida Augusta Ada Byron, (Londres, 10 de diciembre de 1815 – Londres, 27 de noviembre de 1852), conocida habitualmente como Ada Lovelace, fue una matemática británica. Su padre fue el conocido poeta Lord Byron.
Ada Lovelace
Augusta Ada King, Condesa de Lovelace, nacida Augusta Ada Byron, (Londres, 10 de diciembre de 1815 – Londres, 27 de noviembre de 1852), conocida habitualmente como Ada Lovelace, fue una matemática británica. Su padre fue el conocido poeta Lord Byron.

Sethembile Msezane
Sethembile Msezane vive y trabaja en Ciudad del Cabo, República Sudafricana. Utilizando performance, fotografía, video, escultura e instalación, su trabajo explora temas relacionados con la espiritualidad, la conmemoración y los conocimientos ancestrales africanos. La artista Sethembile Msezane se convirtió en
Sethembile Msezane
Sethembile Msezane vive y trabaja en Ciudad del Cabo, República Sudafricana. Utilizando performance, fotografía, video, escultura e instalación, su trabajo explora temas relacionados con la espiritualidad, la conmemoración y los conocimientos ancestrales africanos. La artista Sethembile Msezane se convirtió en

Llaneros Solitarios. Hackers, la Guerrilla Informática
Lxs autores de este libro son Fernando Bonsembiante y Raquel Roberti y trata acerca de la historia del hacking en Argentina. La primera edición es de 1995 por la editorial Espasa Calpe, Buenos Aires, Argentina. Los hackers deberán ser juzgados
Llaneros Solitarios. Hackers, la Guerrilla Informática
Lxs autores de este libro son Fernando Bonsembiante y Raquel Roberti y trata acerca de la historia del hacking en Argentina. La primera edición es de 1995 por la editorial Espasa Calpe, Buenos Aires, Argentina. Los hackers deberán ser juzgados

Eduardo Kac
Eduardo Kac (Brasil, 1962). En los años ochenta comenzó a desarrollar su carrera artística, cultivando un performance por semana. Más tarde en 1989 viajó a Chicago para estudiar en la Escuela del Instituto de Arte de Chicago, donde obtuvo una
Eduardo Kac
Eduardo Kac (Brasil, 1962). En los años ochenta comenzó a desarrollar su carrera artística, cultivando un performance por semana. Más tarde en 1989 viajó a Chicago para estudiar en la Escuela del Instituto de Arte de Chicago, donde obtuvo una

TUPAC
La supercomputadora Tupac, es un clúster computacional dirigido a la resolución de modelos de simulación utilizando técnicas de computación de alto rendimiento. El clúster Tupac equivaldría a 12 000 computadoras hogareñas (tomando como base de equivalencia promedio un procesador Core i5 3470). Está ubicada en el Centro de Simulación Computacional
TUPAC
La supercomputadora Tupac, es un clúster computacional dirigido a la resolución de modelos de simulación utilizando técnicas de computación de alto rendimiento. El clúster Tupac equivaldría a 12 000 computadoras hogareñas (tomando como base de equivalencia promedio un procesador Core i5 3470). Está ubicada en el Centro de Simulación Computacional
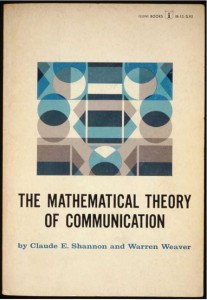
Claude Shannon
Claude Elwood Shannon (EEUU 1916 2001) fue un matemático, ingeniero eléctrico y criptógrafo reconocido como «el padre de la teoría de la información». Shannon es reconocido por haber fundado el campo de la teoría de la información con la publicación
Claude Shannon
Claude Elwood Shannon (EEUU 1916 2001) fue un matemático, ingeniero eléctrico y criptógrafo reconocido como «el padre de la teoría de la información». Shannon es reconocido por haber fundado el campo de la teoría de la información con la publicación

LoVid
LoVid es un dúo artístico interdisciplinario formado por Tali Hinkis (USA 1974) y Kyle (USA 1976) Lapidus. Sus trabajos incluyen instalaciones de vídeo, esculturas, impresiones digitales, patchwork, proyectos multimedia, performances y grabaciones de vídeo. En su trabajo se combinan muchos
LoVid
LoVid es un dúo artístico interdisciplinario formado por Tali Hinkis (USA 1974) y Kyle (USA 1976) Lapidus. Sus trabajos incluyen instalaciones de vídeo, esculturas, impresiones digitales, patchwork, proyectos multimedia, performances y grabaciones de vídeo. En su trabajo se combinan muchos
ImageNet Roulette
ImageNet Roulette, página web creada por Kate Crawford y Trevor Paglen, que se encuentra actualmente desactivada y solo funcionando como instalación artística. Era un sitio web que buscaba mostrar las problemáticas de cómo los humanos son clasificados en sistemas de
ImageNet Roulette
ImageNet Roulette, página web creada por Kate Crawford y Trevor Paglen, que se encuentra actualmente desactivada y solo funcionando como instalación artística. Era un sitio web que buscaba mostrar las problemáticas de cómo los humanos son clasificados en sistemas de

Memoria Electrónica
Publicidad de la empresa Engineering Research Associates Division, ERA, publicada en la Revista Scientific American en abril de 1953. “La memoria electrónica confiable” Ofrece una “memoria ERA Magnética de tambor de almacenamiento de sistemas automáticos de controles de procesos electrónicos
Memoria Electrónica
Publicidad de la empresa Engineering Research Associates Division, ERA, publicada en la Revista Scientific American en abril de 1953. “La memoria electrónica confiable” Ofrece una “memoria ERA Magnética de tambor de almacenamiento de sistemas automáticos de controles de procesos electrónicos

Historia de la computación
AutoCAD before AutoCAD. Chilton Computing Photographs El sitio Chilton Computing es un archivo de reporte y fotografías que documentan a los trabajadores, los computadores y los trabajos realizados por varios Departamentos de Computación en el “Atlas Computer and Rutherford Appleton
Historia de la computación
AutoCAD before AutoCAD. Chilton Computing Photographs El sitio Chilton Computing es un archivo de reporte y fotografías que documentan a los trabajadores, los computadores y los trabajos realizados por varios Departamentos de Computación en el “Atlas Computer and Rutherford Appleton

Conifer (ex Webrecorder)
Conifer (ex Webrecorder) es un servicio de archivo web gratuito que cualquiera puede usar para guardar páginas web. Hacer una captura de una página web es tan fácil como navegar normalmente por Internet. Webrecorder archiva automáticamente la página, junto con cualquier
Conifer (ex Webrecorder)
Conifer (ex Webrecorder) es un servicio de archivo web gratuito que cualquiera puede usar para guardar páginas web. Hacer una captura de una página web es tan fácil como navegar normalmente por Internet. Webrecorder archiva automáticamente la página, junto con cualquier

Deepfake
Deepfake es un término en inglés conformado por las palabras fake (falso) y deep learning (aprendizaje profundo). Es una técnica de inteligencia artificial que permite editar videos o audios reales agregando los rasgos faciales de otra persona, utilizando algoritmos de
Deepfake
Deepfake es un término en inglés conformado por las palabras fake (falso) y deep learning (aprendizaje profundo). Es una técnica de inteligencia artificial que permite editar videos o audios reales agregando los rasgos faciales de otra persona, utilizando algoritmos de

P2P
Peer-to-peer viene del inglés y significa de igual a igual. Se trata de un método de intercambio de archivos, ya sean aplicaciones, programas, fotos o vídeos, entre dos o más usuarios. Es un sistema de comunicación descentralizado en la que
P2P
Peer-to-peer viene del inglés y significa de igual a igual. Se trata de un método de intercambio de archivos, ya sean aplicaciones, programas, fotos o vídeos, entre dos o más usuarios. Es un sistema de comunicación descentralizado en la que
Distinta Categoría

Filmstory
Es una web interactiva en desarrollo de Matt Richardson en la New York University, que permite al usuario hacer una exploración histórica a través de una revisión sobre el arte cinematográfico. La web se basa en la premisa de que
Filmstory
Es una web interactiva en desarrollo de Matt Richardson en la New York University, que permite al usuario hacer una exploración histórica a través de una revisión sobre el arte cinematográfico. La web se basa en la premisa de que

Processing
Processing es un lenguaje de programación orientada a objetos, entorno de desarrollo integrado y comunidad online de código abierto y gratuito basado en Java y que sirve como medio para la enseñanza y producción de proyectos multimedia e interactivos de
Processing
Processing es un lenguaje de programación orientada a objetos, entorno de desarrollo integrado y comunidad online de código abierto y gratuito basado en Java y que sirve como medio para la enseñanza y producción de proyectos multimedia e interactivos de

Spacewar!
Spacewar es considerado como uno de los primeros video juegos interactivos de ordenador, desarrollado en 1961 por Steve Russell en una PDP-1. Spacewar era un juego pensado para dos jugadores que se enfrentaban en una batalla entre dos naves espaciales, que debían intentar destruirse
Spacewar!
Spacewar es considerado como uno de los primeros video juegos interactivos de ordenador, desarrollado en 1961 por Steve Russell en una PDP-1. Spacewar era un juego pensado para dos jugadores que se enfrentaban en una batalla entre dos naves espaciales, que debían intentar destruirse

Carlos Santa
Carlos Santa (Colombia, 1957). Artista plástico y realizador audiovisual. Es considerado un pionero de la animación en Colombia. En sus trabajos experimenta con diferentes técnicas pictóricas como pintura, tiza sobre tablero, dibujo, entre otros. Sus trabajos son particularmente artesanales y
Carlos Santa
Carlos Santa (Colombia, 1957). Artista plástico y realizador audiovisual. Es considerado un pionero de la animación en Colombia. En sus trabajos experimenta con diferentes técnicas pictóricas como pintura, tiza sobre tablero, dibujo, entre otros. Sus trabajos son particularmente artesanales y

Centro para la Musica Visual
El Centro de Música Visual (CVM) es un archivo fílmico sin fines de lucro dedicado a la música visual, la animación experimental y medios abstractos. El CVM esta comprometido con la preservación, conservación, educación, becas y la difusión de películas, presentaciones
Centro para la Musica Visual
El Centro de Música Visual (CVM) es un archivo fílmico sin fines de lucro dedicado a la música visual, la animación experimental y medios abstractos. El CVM esta comprometido con la preservación, conservación, educación, becas y la difusión de películas, presentaciones

Paper circuits
“Paper circuits” instalación de sonido de los artistas alemanes Christoph Haag, Martin Rumori, Franziska Windisch y Ludwig Zeller. Es una obra que consta de cinco altavoces, cada uno cubierto con una pila de hojas de papel. Con un lápiz preparado
Paper circuits
“Paper circuits” instalación de sonido de los artistas alemanes Christoph Haag, Martin Rumori, Franziska Windisch y Ludwig Zeller. Es una obra que consta de cinco altavoces, cada uno cubierto con una pila de hojas de papel. Con un lápiz preparado

El libro mecánico de Ángela Ruiz Robles
El libro mecánico fue un invento de la educadora española Ángela Ruiz Robles. Este artefacto es considerado un antecendente del libro electrónico. El propósito de este invento era el de facilitar de una forma amena el aprendizaje de los abecedarios
El libro mecánico de Ángela Ruiz Robles
El libro mecánico fue un invento de la educadora española Ángela Ruiz Robles. Este artefacto es considerado un antecendente del libro electrónico. El propósito de este invento era el de facilitar de una forma amena el aprendizaje de los abecedarios

Suwon Lee
Suwon Lee nació en 1977 en Caracas (Venezuela), donde habían emigrado sus padres coreanos poco tiempo antes. Actualmente reside en Madrid, España. Como fotógrafa se formó en París y en Venezuela estudió bajo la tutela de Nelson Garrido. también ha
Suwon Lee
Suwon Lee nació en 1977 en Caracas (Venezuela), donde habían emigrado sus padres coreanos poco tiempo antes. Actualmente reside en Madrid, España. Como fotógrafa se formó en París y en Venezuela estudió bajo la tutela de Nelson Garrido. también ha

Imaginación e invención
Imaginación e invención, es un libro del filósofo francés Gilbert Simondon basado en los cursos sobre esos temas que dictó entre 1965 y 1966. El libro organiza y cataloga con sumo detalle los procesos relativos a la construcción de sensibilidad y
Imaginación e invención
Imaginación e invención, es un libro del filósofo francés Gilbert Simondon basado en los cursos sobre esos temas que dictó entre 1965 y 1966. El libro organiza y cataloga con sumo detalle los procesos relativos a la construcción de sensibilidad y

PointerPointer
pointerpointer.com es una web intercativa desarrollada en 2012 por Studio Puckey. En este página, el usuario coloca el cursor en alguna parte de la pantalla y después de unos segundos, aparece una fotografía con un dedo que señala a ese punto exacto
PointerPointer
pointerpointer.com es una web intercativa desarrollada en 2012 por Studio Puckey. En este página, el usuario coloca el cursor en alguna parte de la pantalla y después de unos segundos, aparece una fotografía con un dedo que señala a ese punto exacto